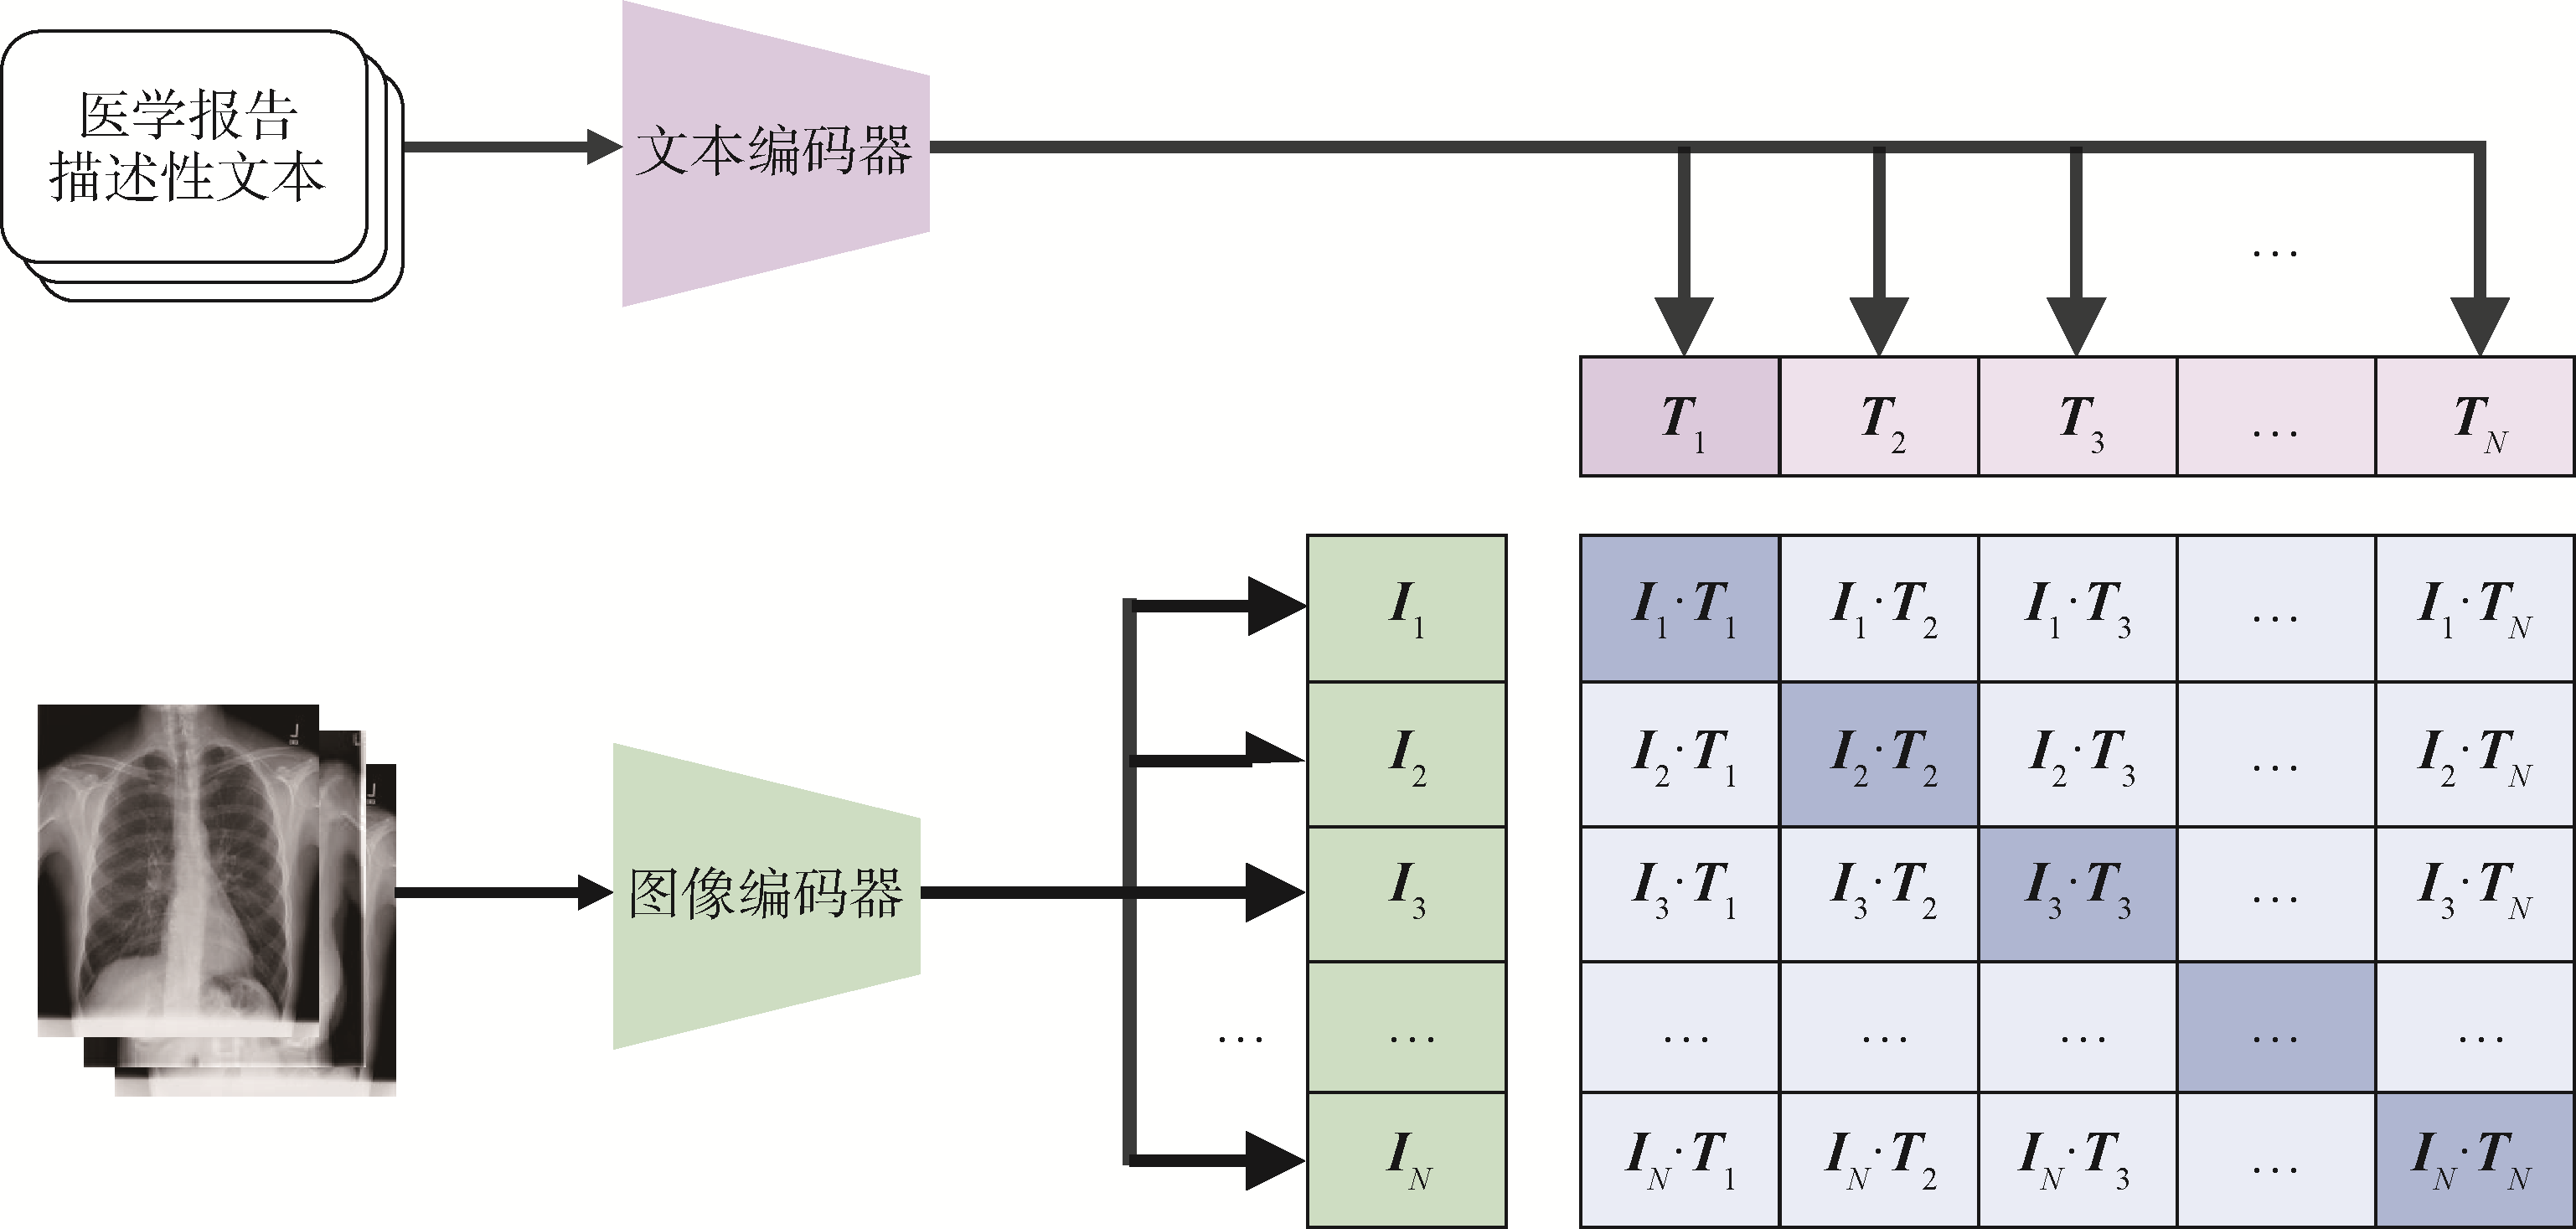
【目的】 对生成式人工智能背景下医学影像报告生成的方法演进与研究成果进行系统梳理,为相关研究方向的后续探索与发展提供参考。【文献范围】 以Google Scholar、ScienceDirect、PubMed、IEEE Xplore、Springer和中国知网数据库为检索来源,以医学影像报告生成、生成式人工智能、深度学习、预训练语言模型、多模态大语言模型、Medical Image Report Generation、Generative Artificial Intelligence、Deep Learning、Pre-Trained Language Model、Multimodal Large Language Model等为检索词进行文献检索,筛选出具有代表性的文献104篇。【方法】 围绕生成式人工智能背景下医学影像报告生成任务的研究进展,构建了一个以技术演进为脉络的系统分类框架,梳理该领域从早期方法到多模态大语言模型的演化路径,并基于经典数据集对比分析多项主流指标上的代表性模型性能,评述现存问题并指出未来研究方向。【结果】 现有方法在跨模态语义融合、语言生成质量与语义一致性等方面取得持续进展,推动医学影像报告生成由关键信息描述向结构完整、术语规范的高质量文本表达发展。【局限】 在研究深度与广度的平衡上有所取舍,不同研究方法的差异使得分析结果存在一定局限性。【结论】 未来研究应重点提升医学影像报告生成模型的泛化性、输出准确性与可解释性,推动构建高质量数据资源与标准化评价指标体系,完善隐私保护与伦理审查机制,并推动模型在真实医疗场景中的验证与落地,以促进其在智慧医疗中的深度应用。
【目的】 揭示智能信息计量的形成过程,呼吁把握智能信息计量的发展机遇,为后续学者研究提供方法参考。【文献范围】 围绕AI在信息计量领域的应用制定检索式,在Web of Science和CNKI数据库中进行检索,经数据精炼和引文检索,最终确定代表性中英文文献进行评述。【方法】 通过系统检索和文献精读,详细梳理和阐述最近10年国内外AI技术在信息计量领域识别、预测和分类方面的应用进展。【结果】 在识别应用方面,AI主要应用于论文识别和细粒度实体识别;在预测应用方面,AI主要应用于论文影响预测、学者影响预测和研究趋势预测;在分类应用方面,AI主要应用于论文学科分类、论文内容分类、情感和动机分类。通过细致的归纳和解读,揭示了每个方向的AI应用原理和过程。【局限】 通过人工方式筛选核心文献,未针对该主题所有文献做分析。【结论】 应用AI技术解决信息计量领域的复杂问题已成为必然趋势,熟练掌握AI技术的应用已成为信息计量领域的关键能力。
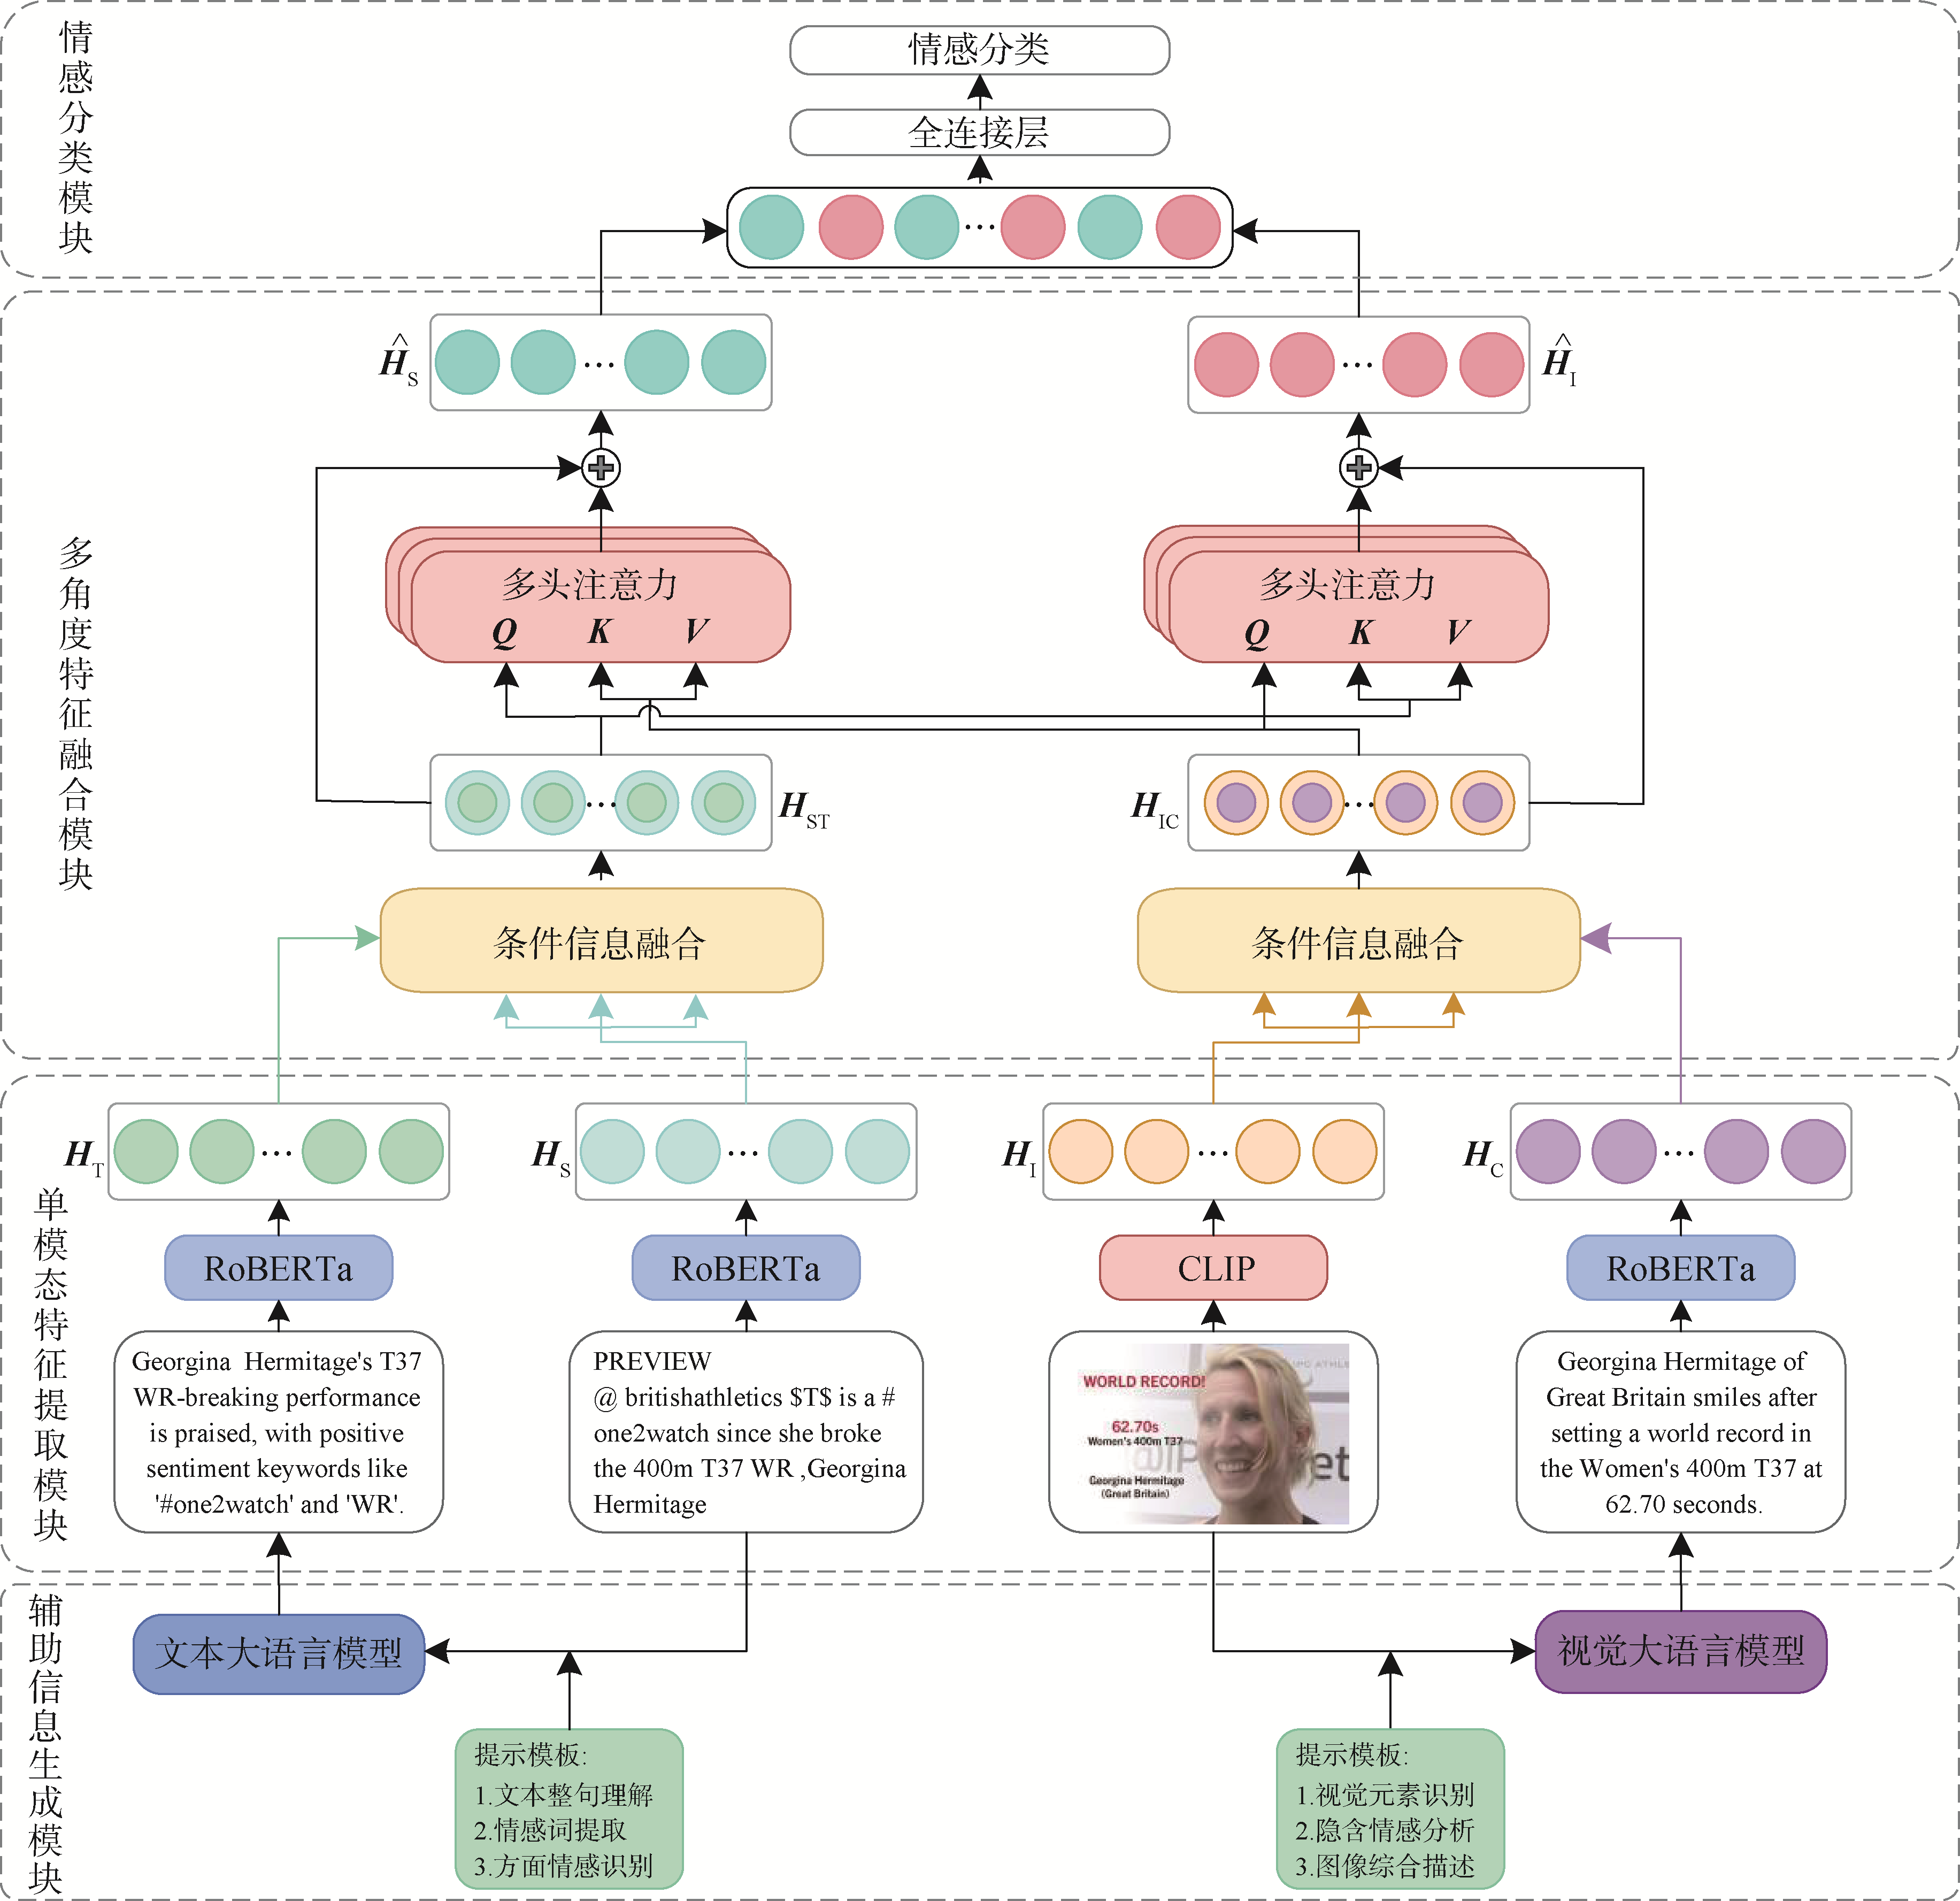
【目的】 为解决情感语义稀疏性问题,同时减少噪声对多模态情感分析的影响,提出一种基于思维链的大模型信息增强和条件信息融合的多模态情感分析方法。【方法】 首先通过构建文本与图像双通道思维链提示模板,引导大模型生成与情感语义高度相关的辅助信息以增强输入数据的语义表达;其次采用基于条件归一化的Transformer编码器,分别对文本、图像原始信息及其生成的辅助信息进行深度特征融合;最后应用跨模态注意力机制实现跨模态信息的融合并完成情感分类任务。【结果】 本文方法在Twitter-2015和Twitter-2017两个公开数据集上的准确率和Macro-F1值均高于基线模型。其中,在Twitter-2015数据集上,准确率和Macro-F1值较各指标最佳基线模型分别提高了1.59和2.12个百分点;在Twitter-2017数据集上,准确率和Macro-F1值较各指标最佳基线模型分别提高了1.67和2.93个百分点。【局限】 未能在更多的多模态情感分析数据集上验证方法的有效性。【结论】 本文方法能够有效丰富情感语义信息,同时多角度充分融合图像与文本特征,提升多模态情感分析的效果。
【目的】 为缓解异构模态间固有的语义鸿沟对跨模态融合效率与情感识别性能的限制,提出一种融合大语言模型语义调和网络的多模态情感分析方法LLM-Harmony。【方法】 借助多模态大语言模型生成情感描述文本,使用门控记忆网络对文本进行强化,以凸显情感特征并剔除冗余信息;随后,通过跨模态注意力网络将原始模态与强化后的描述性文本深度融合,缩小模态间的语义分布差异。融合阶段以文本为核心,通过设计层次化融合网络,引导模型从模态特性(独有情感细节)与模态共性(一致性情感线索)两个维度进行优化,实现对多模态信息的全面捕获。【结果】 所提方法在公开数据集CMU-MOSI和CH-SIMS上的效果均优于基线模型。在细粒度情感分类指标上,与DEVA方法相比,LLM-Harmony在CMU-MOSI数据集上的Acc-5和Acc-7分别提升3.55和1.71个百分点,在CH-SIMS数据集上的Acc-3和Acc-5分别提升2.82和6.05个百分点。【局限】 语义调和网络在使用多模态大语言模型生成情感描述信息时,增加了额外的计算资源开销。【结论】 本文有效弥合了多模态间的语义鸿沟,显著提升了情感分析的性能。

【目的】 为提高方面级情感分析模型的可解释性和隐性情感分析能力,提出一种基于有监督微调和强化学习的可解释方面级情感分析方法。【方法】 首先基于DeepSeek-R1模型构建推理数据集;其次对Qwen2.5-7B-Instruct进行有监督微调,设计包含输出格式、答案格式和情感分类准确性三类奖励的复合奖励函数;最后采用群组相对策略优化算法进行强化学习训练。【结果】 在Restaurant14数据集上,所提方法的F1值达到90.22%,较MT-ISA提高1.26个百分点;在Laptop14数据集上,所提方法的隐性情感分类准确率达到91.75%,较MT-ISA提高3.18个百分点。在相应中文数据集上训练后,模型在Lasted和OHC数据集上的F1值分别达到84.63%和91.55%。【局限】 仅对方面级情感分类任务进行实验,未扩展到更为复杂的情感信息抽取等任务。【结论】 所提方法提高了隐性情感分类准确率,增强了情感分类结果的可解释性,在中英文数据集上具有良好稳健性;合理的复合奖励函数对于模型优化至关重要。

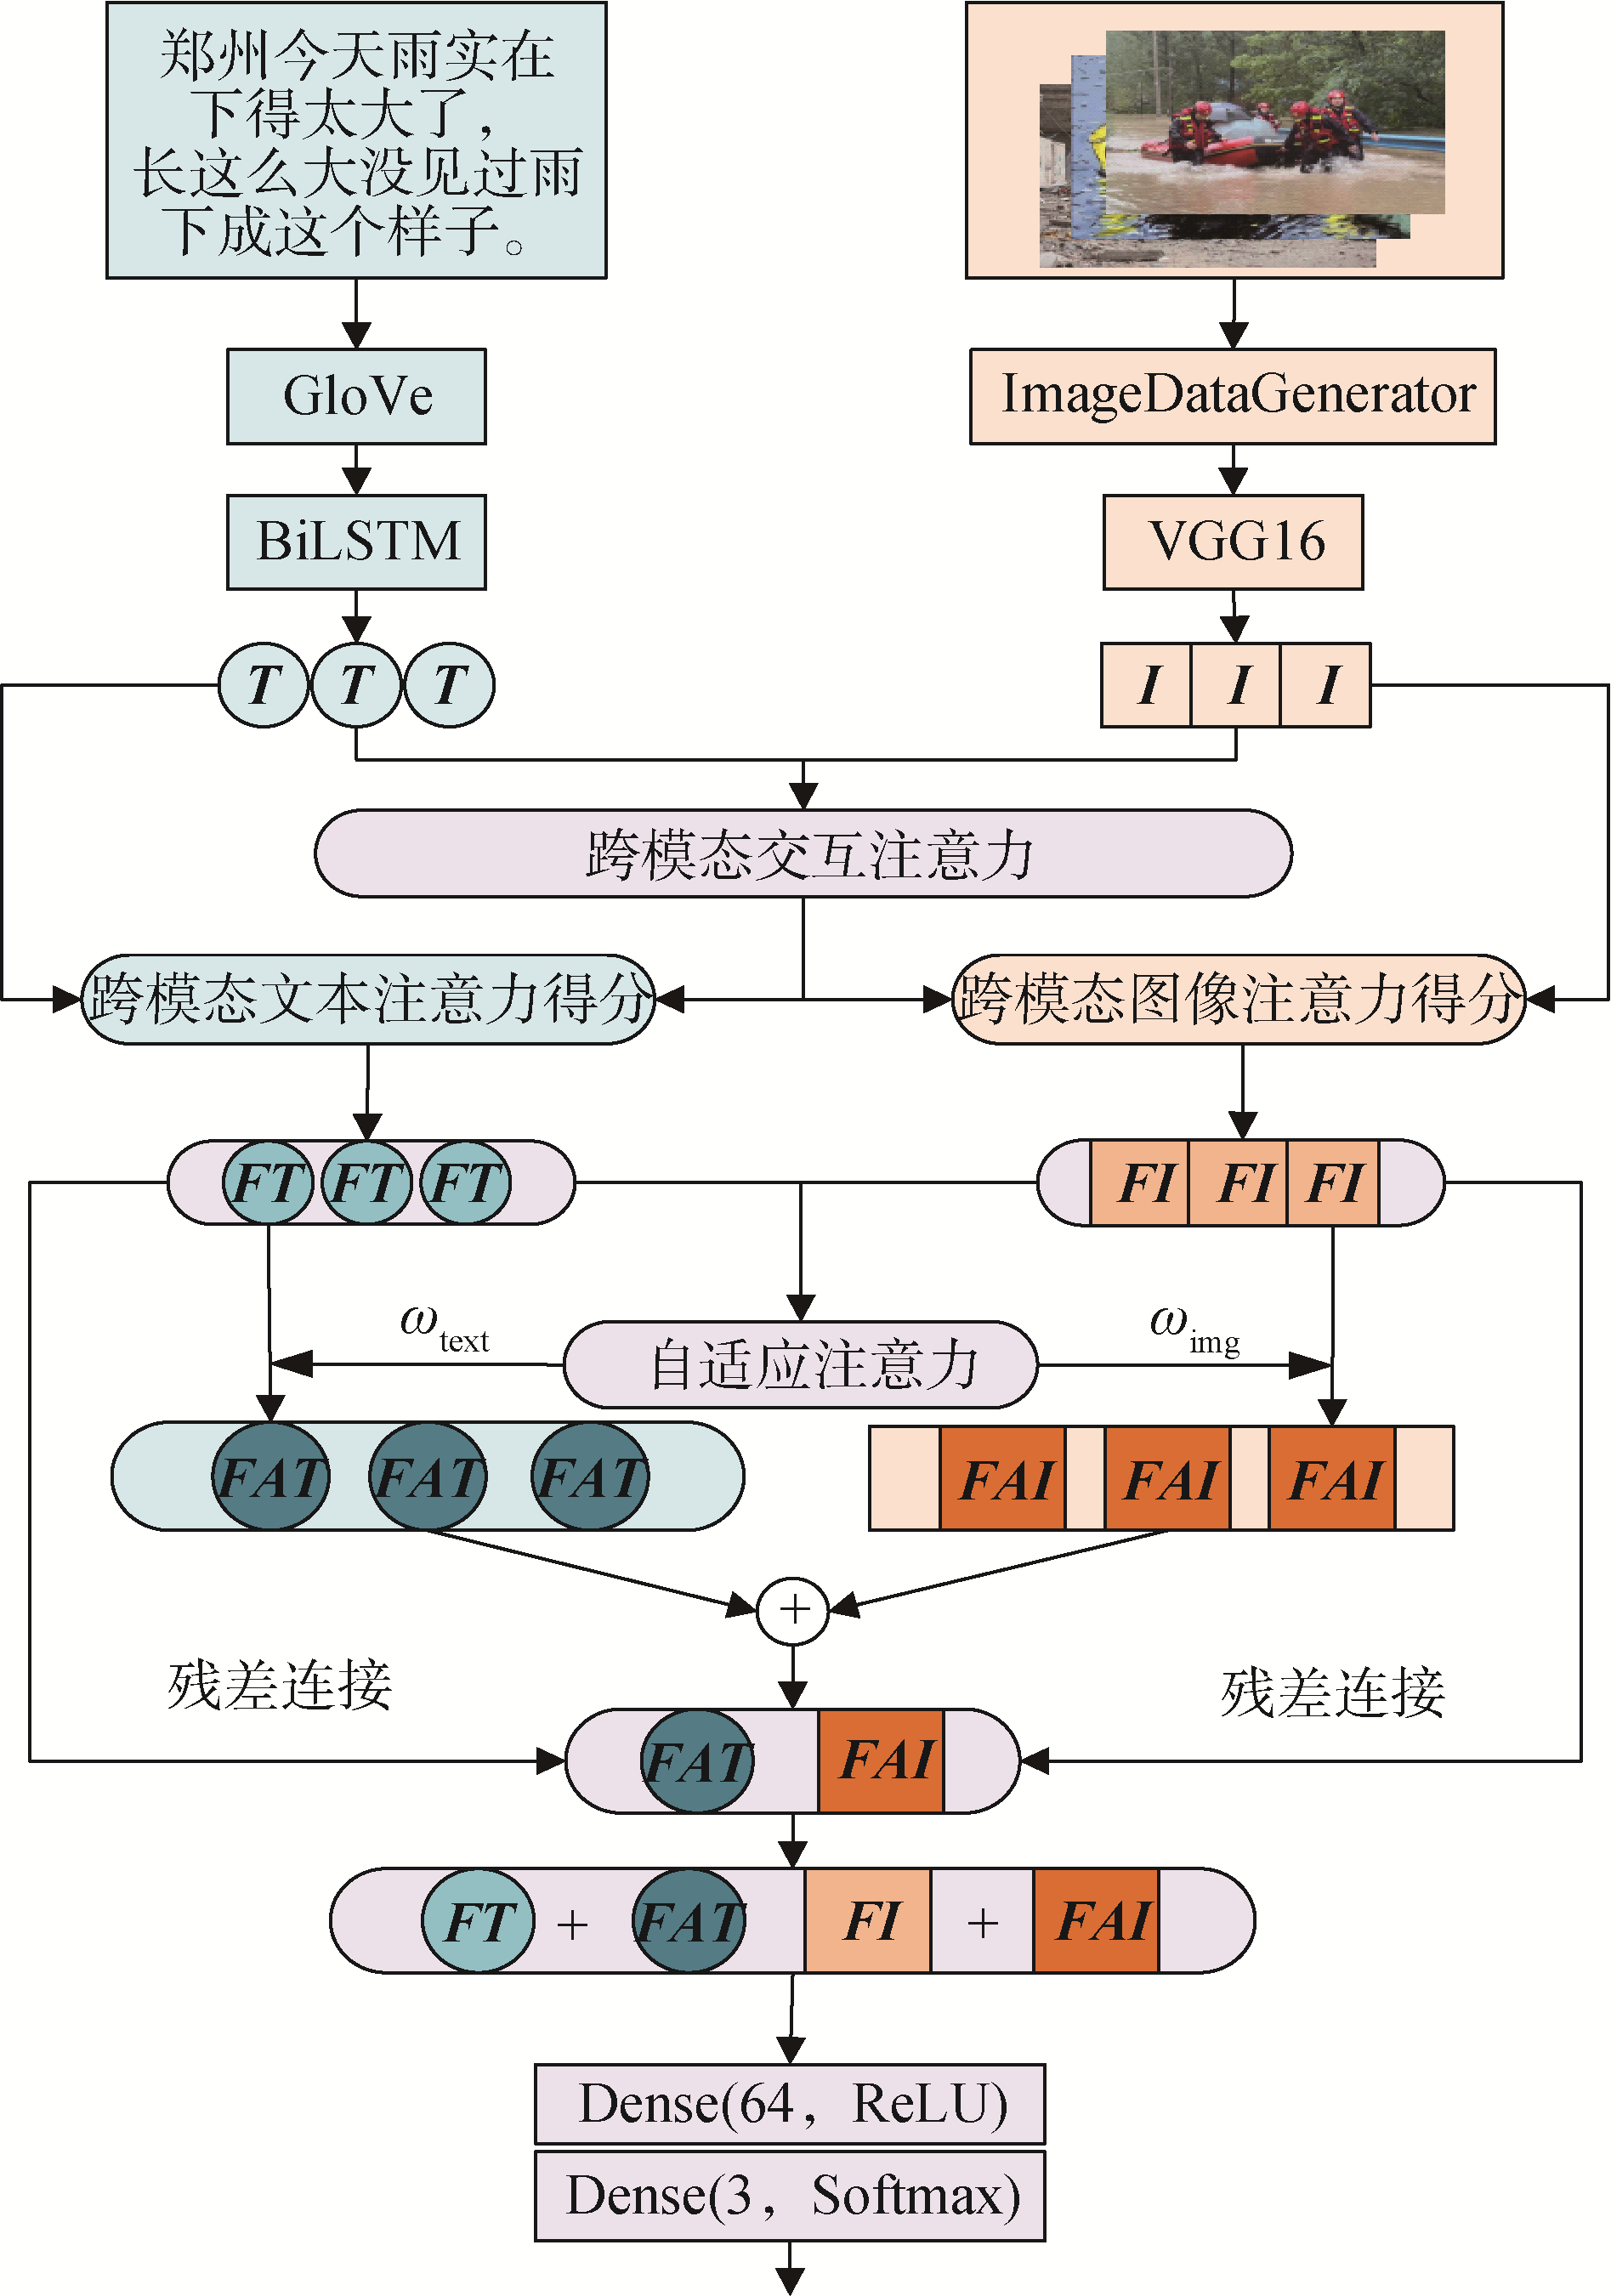
【目的】 针对现有突发事件舆情情感分析中图文特征数据量不匹配、图文交互影响关系考量不充分等问题,提出一种基于自适应跨模态融合注意力的突发事件舆情情感分析模型。【方法】 首先,采用图像增强技术对突发事件舆情图像特征进行增强,对齐图文数据;其次,引入两阶段跨模态交互注意力,充分衡量突发事件舆情中图像与文本模态之间的深层关联,增强模态间的互补信息表达,进一步引入自适应注意力,根据不同模态在情感识别任务中的贡献动态分配权重,实现跨模态特征的有效融合;最后,引入残差连接对跨模态融合特征进行处理,提高模型的泛化能力。【结果】 将模型应用于三起突发事件的舆情情感分析,三组对比实验验证模型综合准确率达到93.68%,综合召回率达到93.15%。【局限】 本文模型仅基于图文两种模态数据的交互影响关系构建,未考虑更多元模态。【结论】 本文构建的模型充分衡量突发事件舆情图文特征之间的交互影响关系,实现了跨模态特征的动态融合,优化了梯度传播和信息流传递,并在深层网络中仍能保持较高的性能,提高了突发事件舆情多模态情感分析的准确性。
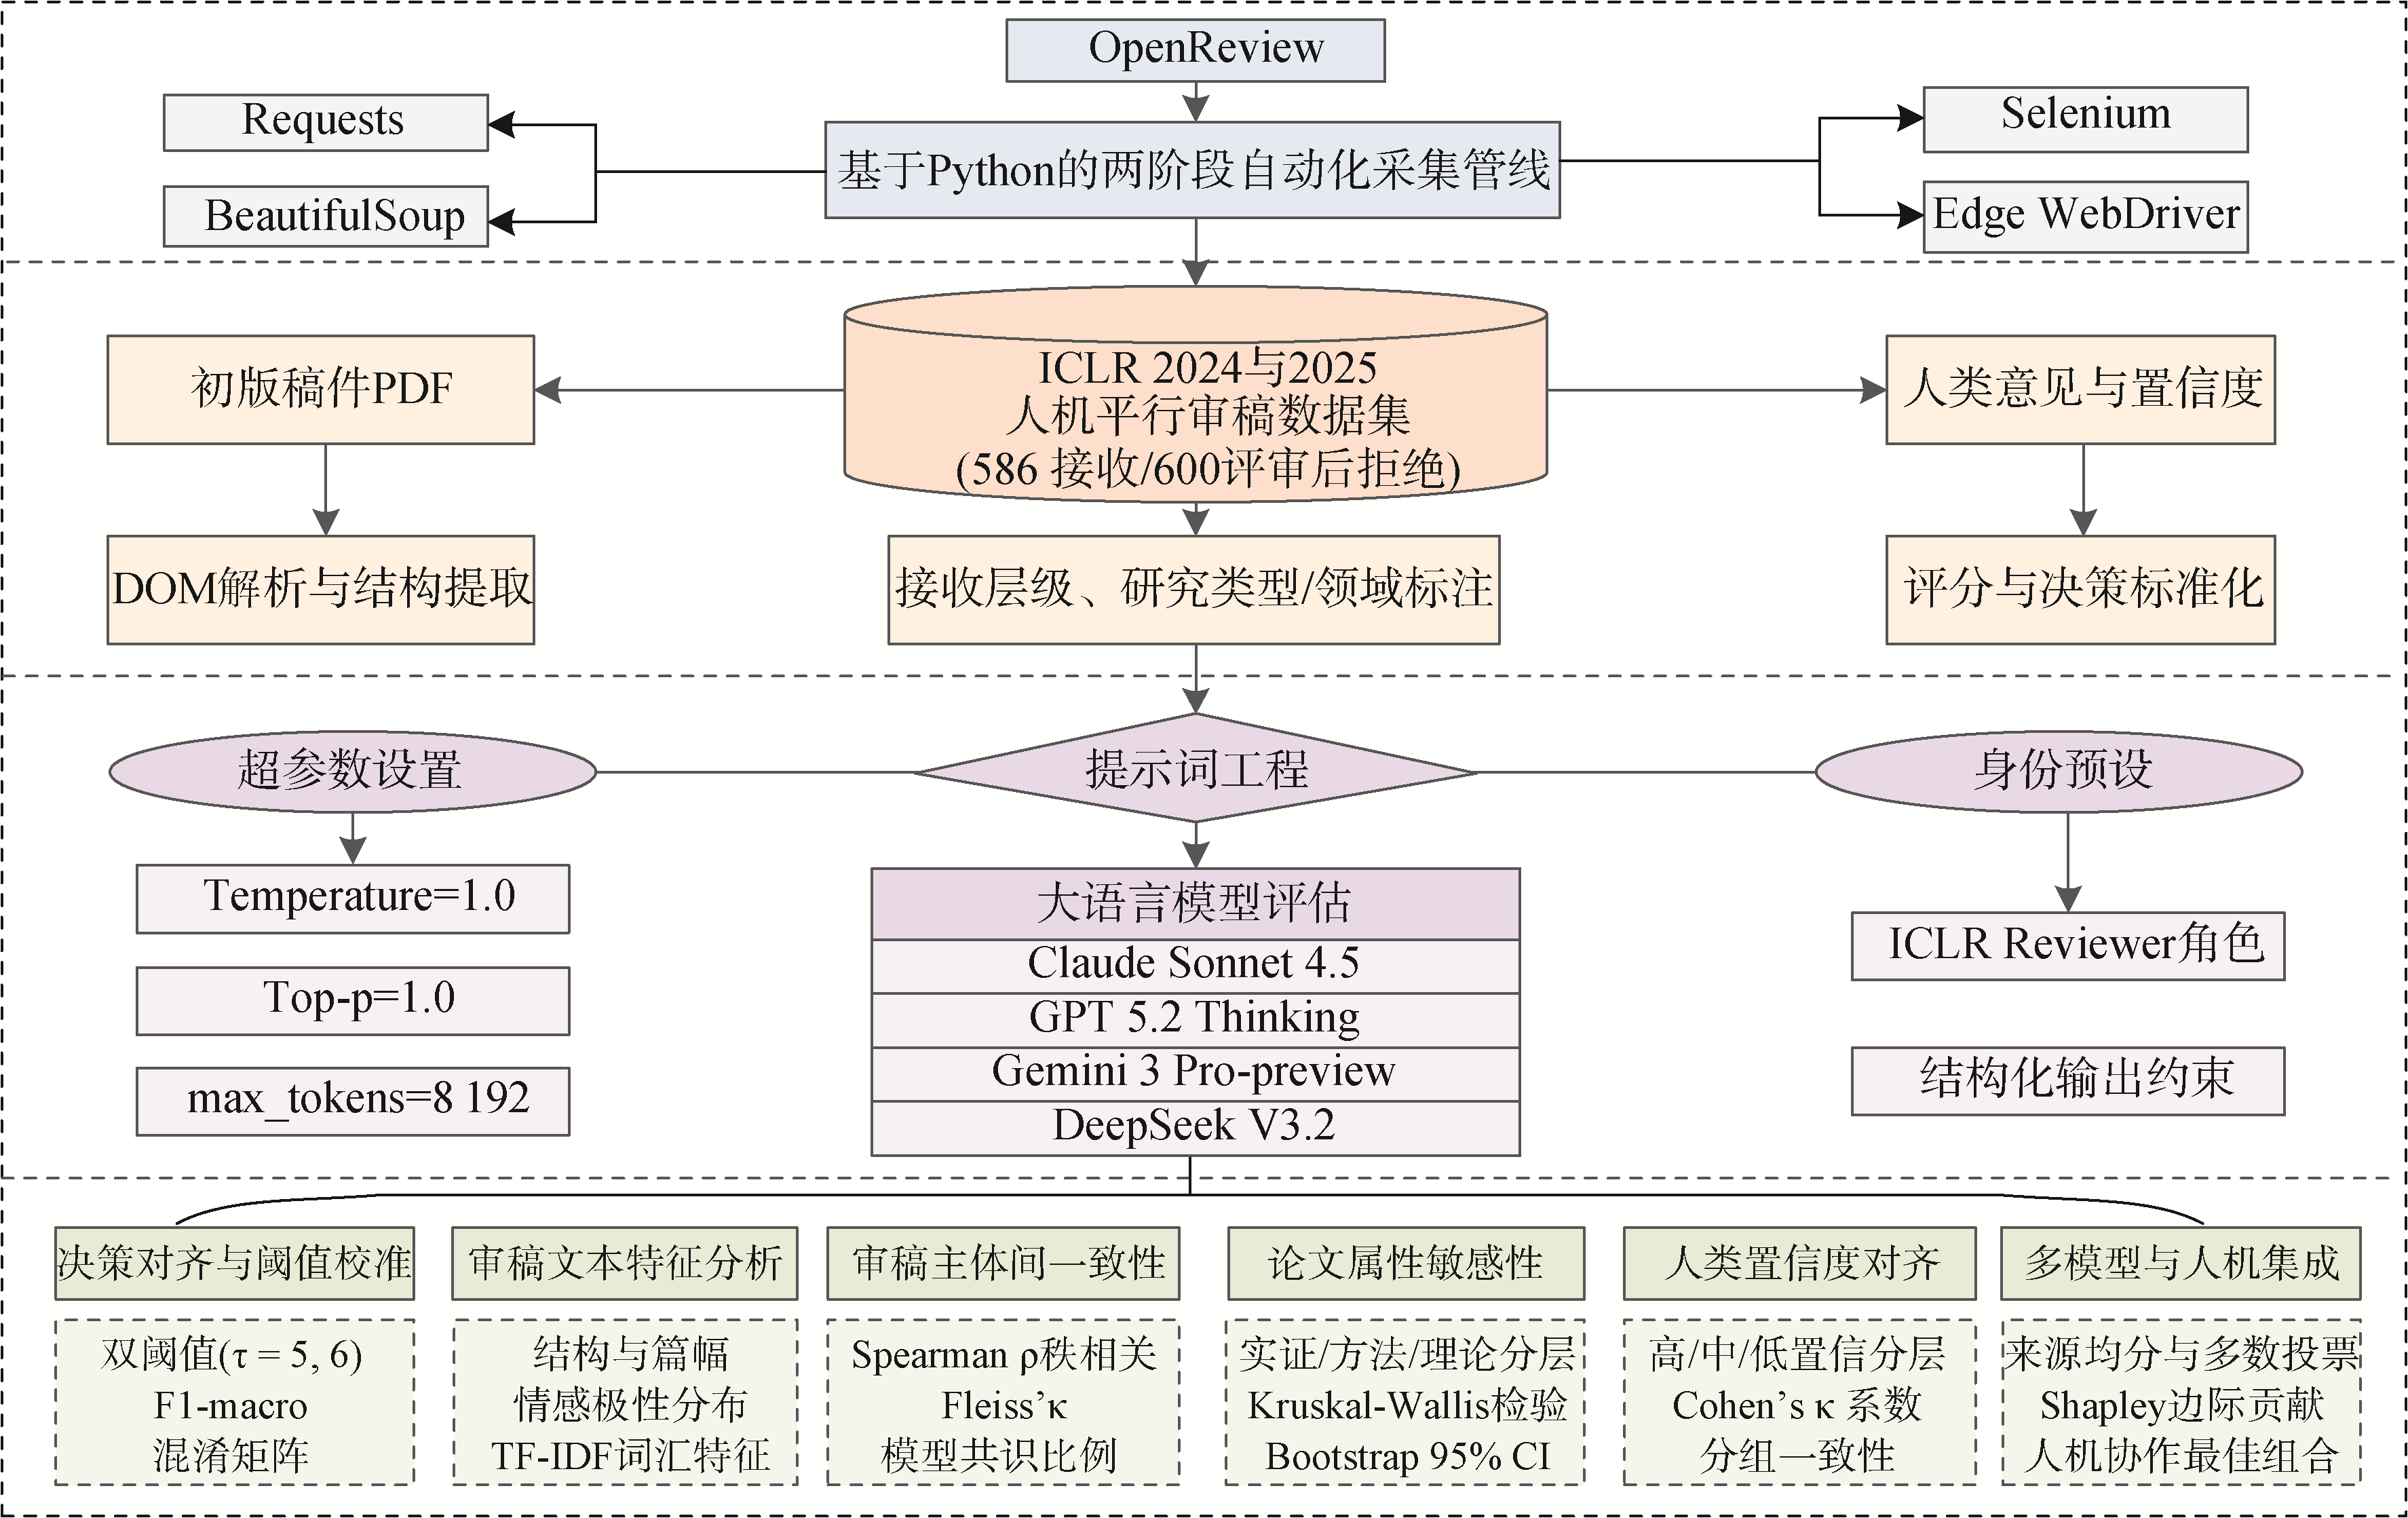
【目的】 为检验大语言模型(LLMs)审稿评分的偏置及其校准效果,评估多模型集成与人机协作对录用决策对齐的影响。【方法】 以2024年与2025年国际学习表征会议(ICLR)论文评审为场景,基于4 655份人类审稿意见和18 620份AI审稿意见,比较4种模型在决策对齐、文本特征、一致性及人机协作方面的表现。【结果】 LLMs原始评分普遍存在高分偏置与层级压缩,在标准阈值下易产生过接收倾向,经阈值校准后,其与真实录用结果的对齐水平显著提升。LLMs审稿意见在结构完整性和语言组织上已接近人类评审,但在批评深度、情感区分和质量层级辨识方面仍有不足。阈值校准后,人机协同最优策略取得最高准确率0.964,较最佳单一LLMs提升0.073。【局限】 仅基于ICLR单一会议的2024、2025两届数据,样本范围和模型版本的局限可能影响结论的外推性。【结论】 现阶段LLMs还难以替代人类承担独立审稿职责,但可作为审稿辅助与人机协同评审机制的重要组成部分。
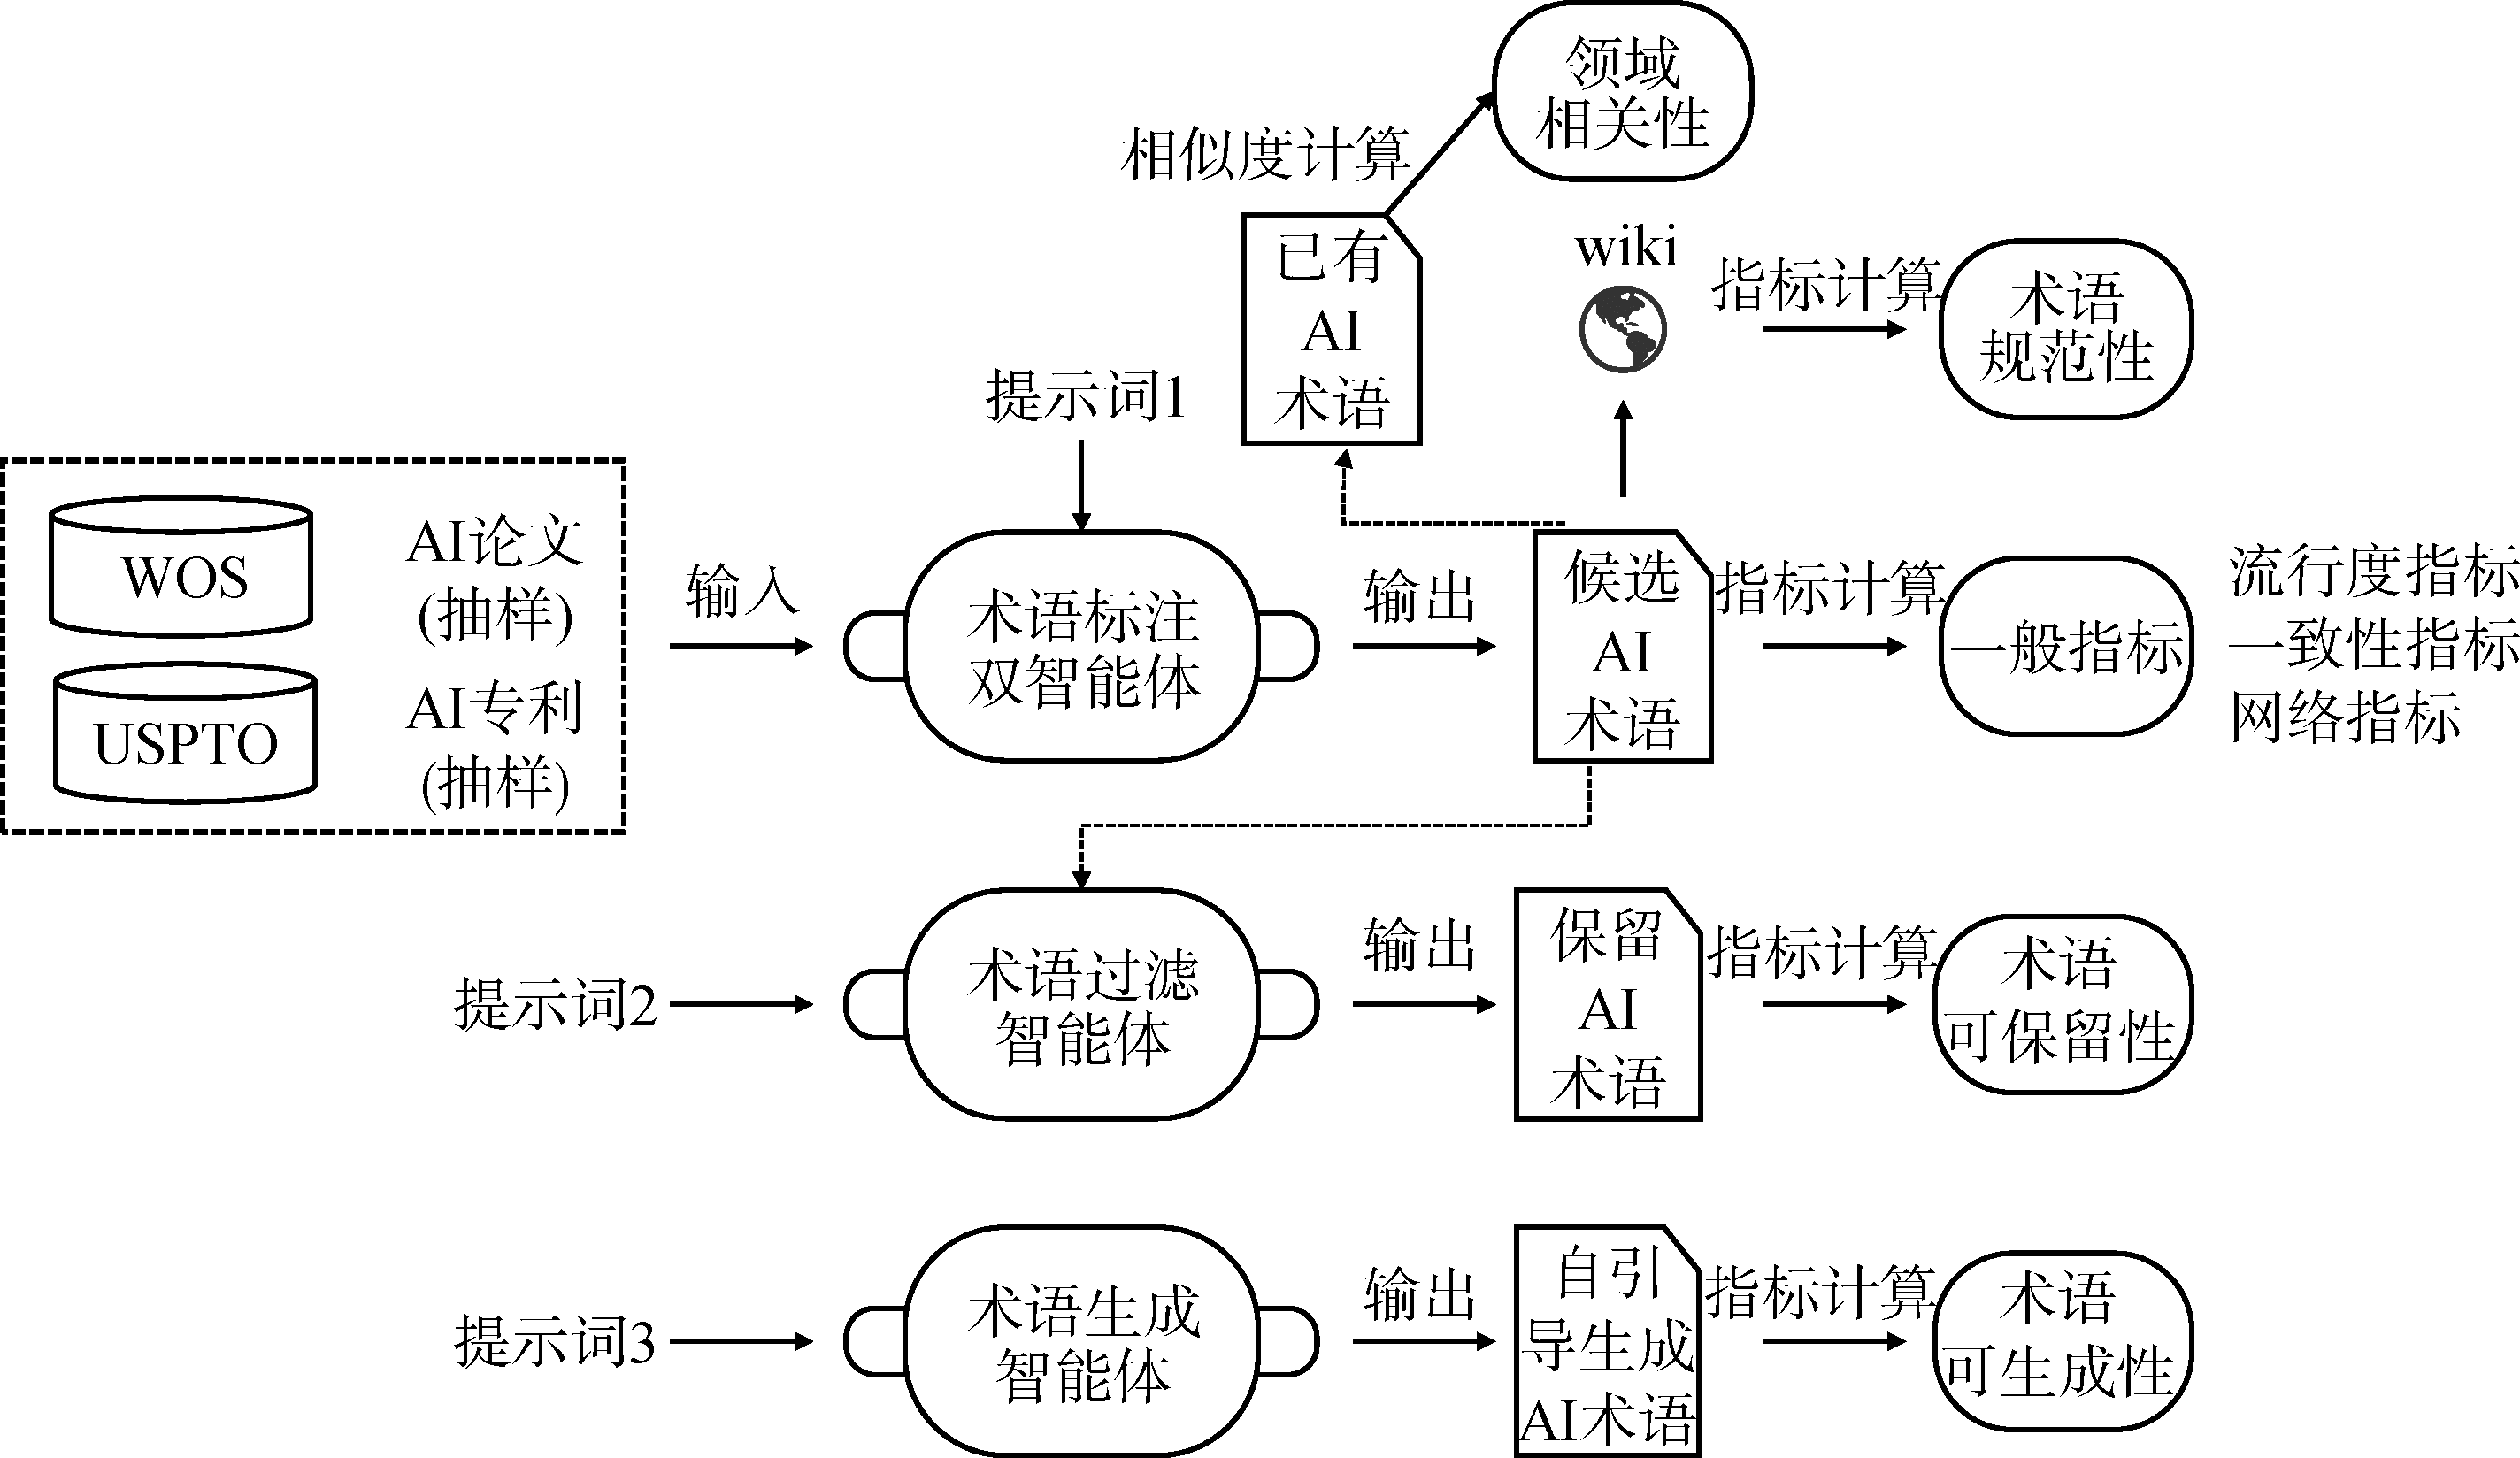
【目的】 提出一种基于多智能体协作与混合指标测度的术语提取方法,旨在缓解基于大语言模型术语提取方法中的幻觉问题与可解释性难题,构建高质量人工智能术语集合。【方法】 通过异质双智能体(DeepSeek V3与GPT-4o Mini)协同提取候选人工智能术语,并构建融合单元性、术语性及多智能体协同一致性的混合指标测度体系,对术语质量进行分层度量与排序。实验基于大规模论文与专利语料展开,并结合专家评分与消融实验对方法有效性进行验证。【结果】 基于专家评分结果,各层次术语呈现出显著组间差异,在领域相关性与词汇专一性两个维度上的H值分别达到98.05与94.26(P-value<0.001)。消融实验显示,保留智能体协作相关指标的相关系数比剔除后平均高出约17个百分点。【局限】 未采用高性能版本的大模型,且方法未覆盖全部语料,可能忽略了某些术语特征。【结论】 混合指标测度能够区分术语的质量层级,从而筛除低质量术语。多智能体协作机制在提升指标体系对术语质量层级的区分能力方面展现出独特作用。
【目的】 针对学术文献数量激增所引发的信息过载问题以及传统推荐系统在语义理解与可解释性等方面的局限,提出一种融合大语言模型与图增强的学术文献推荐框架,以期为学术领域智能推荐服务提供更加精准透明的解决方案。【方法】 本研究构建了一个生成式学术文献推荐框架。首先利用大语言模型提取文献深层语义特征并构建异构学术图;其次通过优化的检索策略高效筛选候选文献,并利用大语言模型结合图信息对候选文献进行语义重排序;最后引入基于路径的可解释性机制,为推荐结果提供深层次解释。【结果】 在WoSCite、CiteULike和ICF三个学术数据集上的实验结果表明,所提框架在准确率和召回率指标上相较最优基线模型的平均相对提升分别不低于12.3%和11.3%,同时在推荐结果可解释性评估中,平均综合得分由5.6提升至7.2。【局限】 所提框架在学术异构图构建与检索中存在较高的计算与存储资源消耗,同时仅基于静态用户兴趣建模,有待进一步优化以扩展应用范围。【结论】 所提框架能够有效提升学术文献推荐的准确性与可解释性,并为学术信息服务的智能化转型提供切实可行的技术路径。

【目的】 通过增加外部知识和优化大语言模型(LLM)提示方法,解决视觉问答任务多步推理准确率低的问题。【方法】 提出一种新的知识型视觉问答模型KRLP,通过引入PromptCap字幕模型生成图像字幕辅助LLM理解图像区域信息,融合开源与图片语义知识检索增加推理来源。同时,设计新的问题分解方案以降低推理难度,构建相关上下文示例并集成多个推理答案以提升准确性。【结果】 KRLP模型在OK-VQA和A-OKVQA数据集上的准确率分别达到67.2%和64.8%,优于对比模型。消融实验也验证了模型中各个模块的有效性。【局限】 本文模型中的问题分解模块会增加计算和时间开销,解决简单视觉问答问题的效率较低。【结论】 本文模型借助LLM优化知识型视觉问答框架,为多步推理的知识型视觉问答提供了新思路。

【目的】 为解决当前电信网络诈骗风险宣防管控中非结构化数据利用率低、多源信息时空特征割裂的问题,提出一种基于大模型微调与多Agent协同的时空知识图谱构建方法。【方法】 以某省近5年42万余条案件数据为基础,首先构建公安领域专业术语库,并采用LoRA技术对DeepSeek模型进行多任务微调,提升模型对电信网络诈骗案件关键要素的提取能力;然后设计多Agent协同框架,包括预处理、要素提取、冲突检测和整合Agent,通过动态提示模板与逻辑规则引擎实现非结构化文本的解析;最终构建异构特征耦合的电信网络诈骗风险宣防管控时空知识图谱。【结果】 实验表明,微调大模型的BLEU-4指标达49.718,要素提取任务中平均F1值达0.896,并且基于不同类型电信网络诈骗案件文本数据构建的时空知识图谱覆盖率达0.979。【局限】 受限于网络行为核心要素的非结构化、语义碎片化特征,当前微调大模型表现出一定的收敛阈值,对网络行为的识别能力有待进一步提升。【结论】 基于大模型的电信网络诈骗风险宣防管控时空知识图谱构建方法以结构化方式整合了多类案件核心要素,能够有效还原犯罪路径,所构建的知识图谱为犯罪模式挖掘和精准宣防提供坚实的数据支撑。

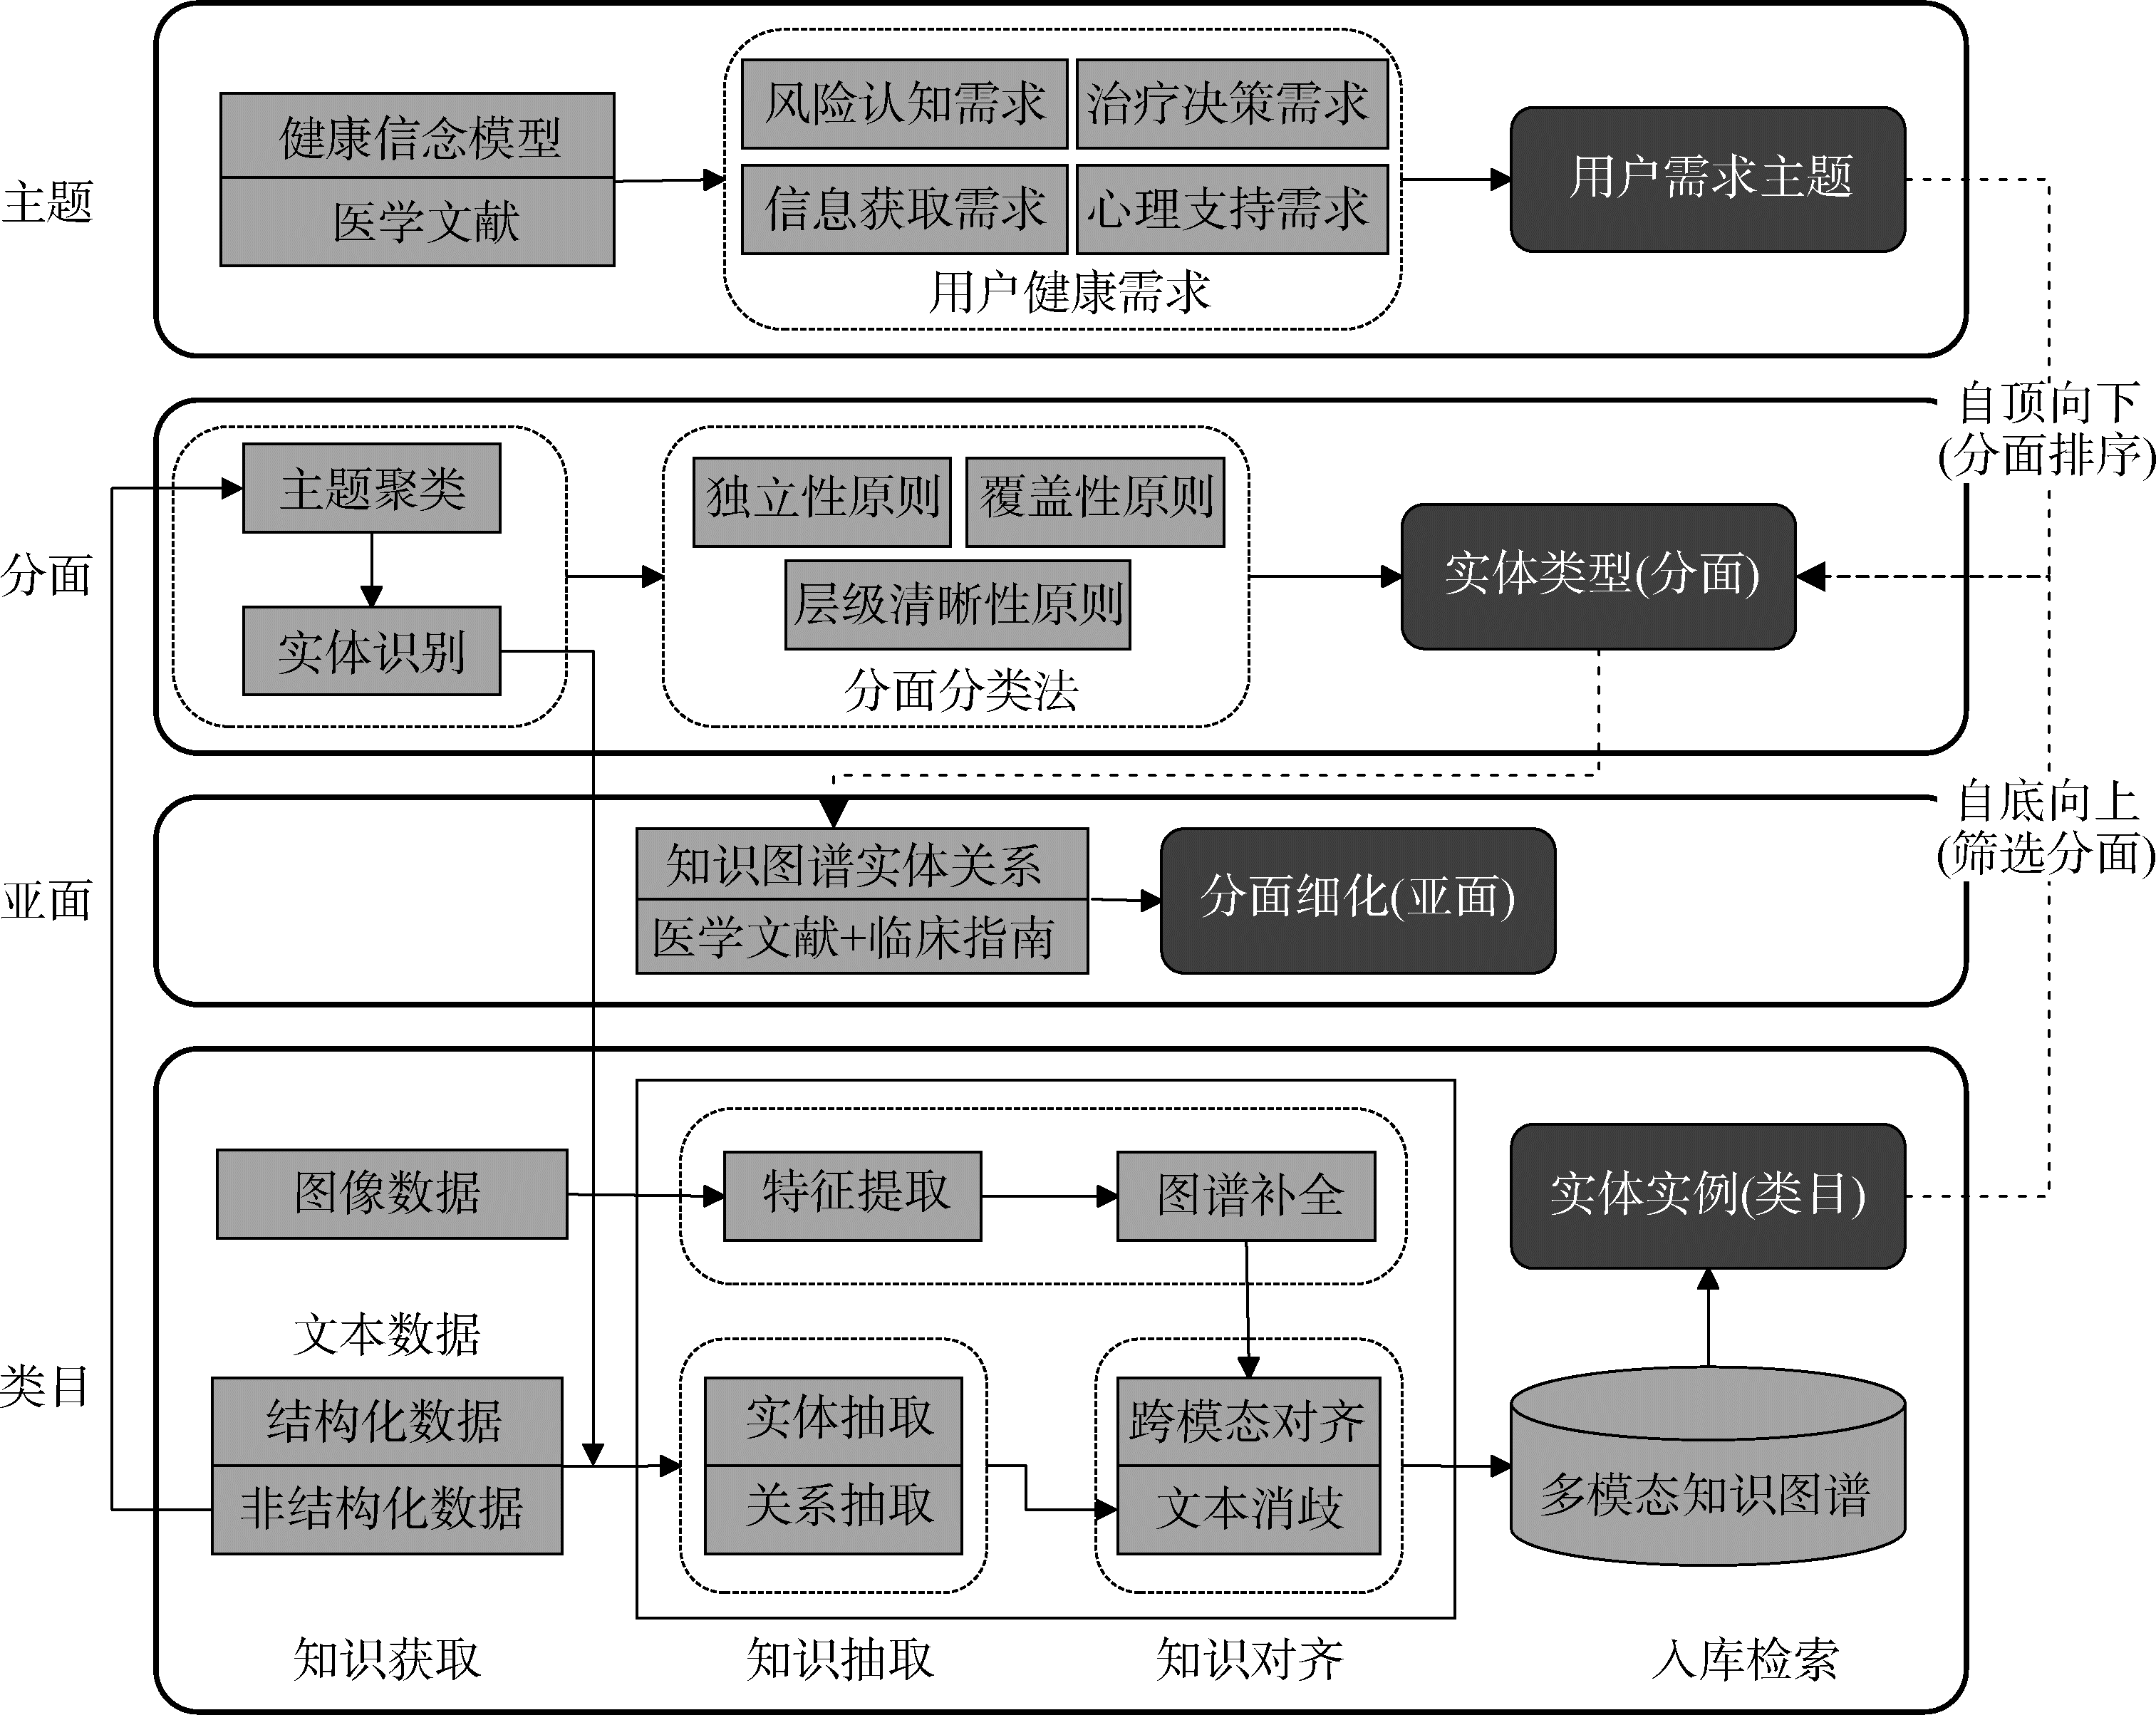
【目的】 构建基于多模态语义理解的分面检索框架,解决现有在线医疗问答社区信息查准和多模态数据利用不足等问题,优化皮肤病问答社区的信息组织。【方法】 利用LDA主题模型进行文本聚类、BERT-BiLSTM-CRF模型进行实体识别,通过ResNet-50提取图像特征,结合跨模态对齐技术实现图文语义关联,构建多模态知识图谱。依据健康信念模型归纳3个用户需求主题,构建“主题-分面-亚面-类目”4级分面体系。基于有来医生网白癜风板块的文本与图像数据,构建分面检索原型系统,并与其他网站的检索结果进行对比分析。【结果】 本文构建的皮肤病多模态知识图谱涵盖12类实体和15种语义关系,包含5 851个实体节点和11 549条关系;分面体系包含3个主题、9个分面和11个亚面。对比显示,原型系统检索结果在页面呈现、信息组织方式、结果相关度三个维度都能更好地满足用户需求。【局限】 实证对比分析中,采用的分面检索评价指标较为单一,主要从定性分析角度开展对比。【结论】 通过自底向上主题聚合与自顶向下需求分析,构建分面分类多层级知识体系,能有效缓解皮肤病问答社区信息过载问题,提升检索精准度及多模态数据利用能力。
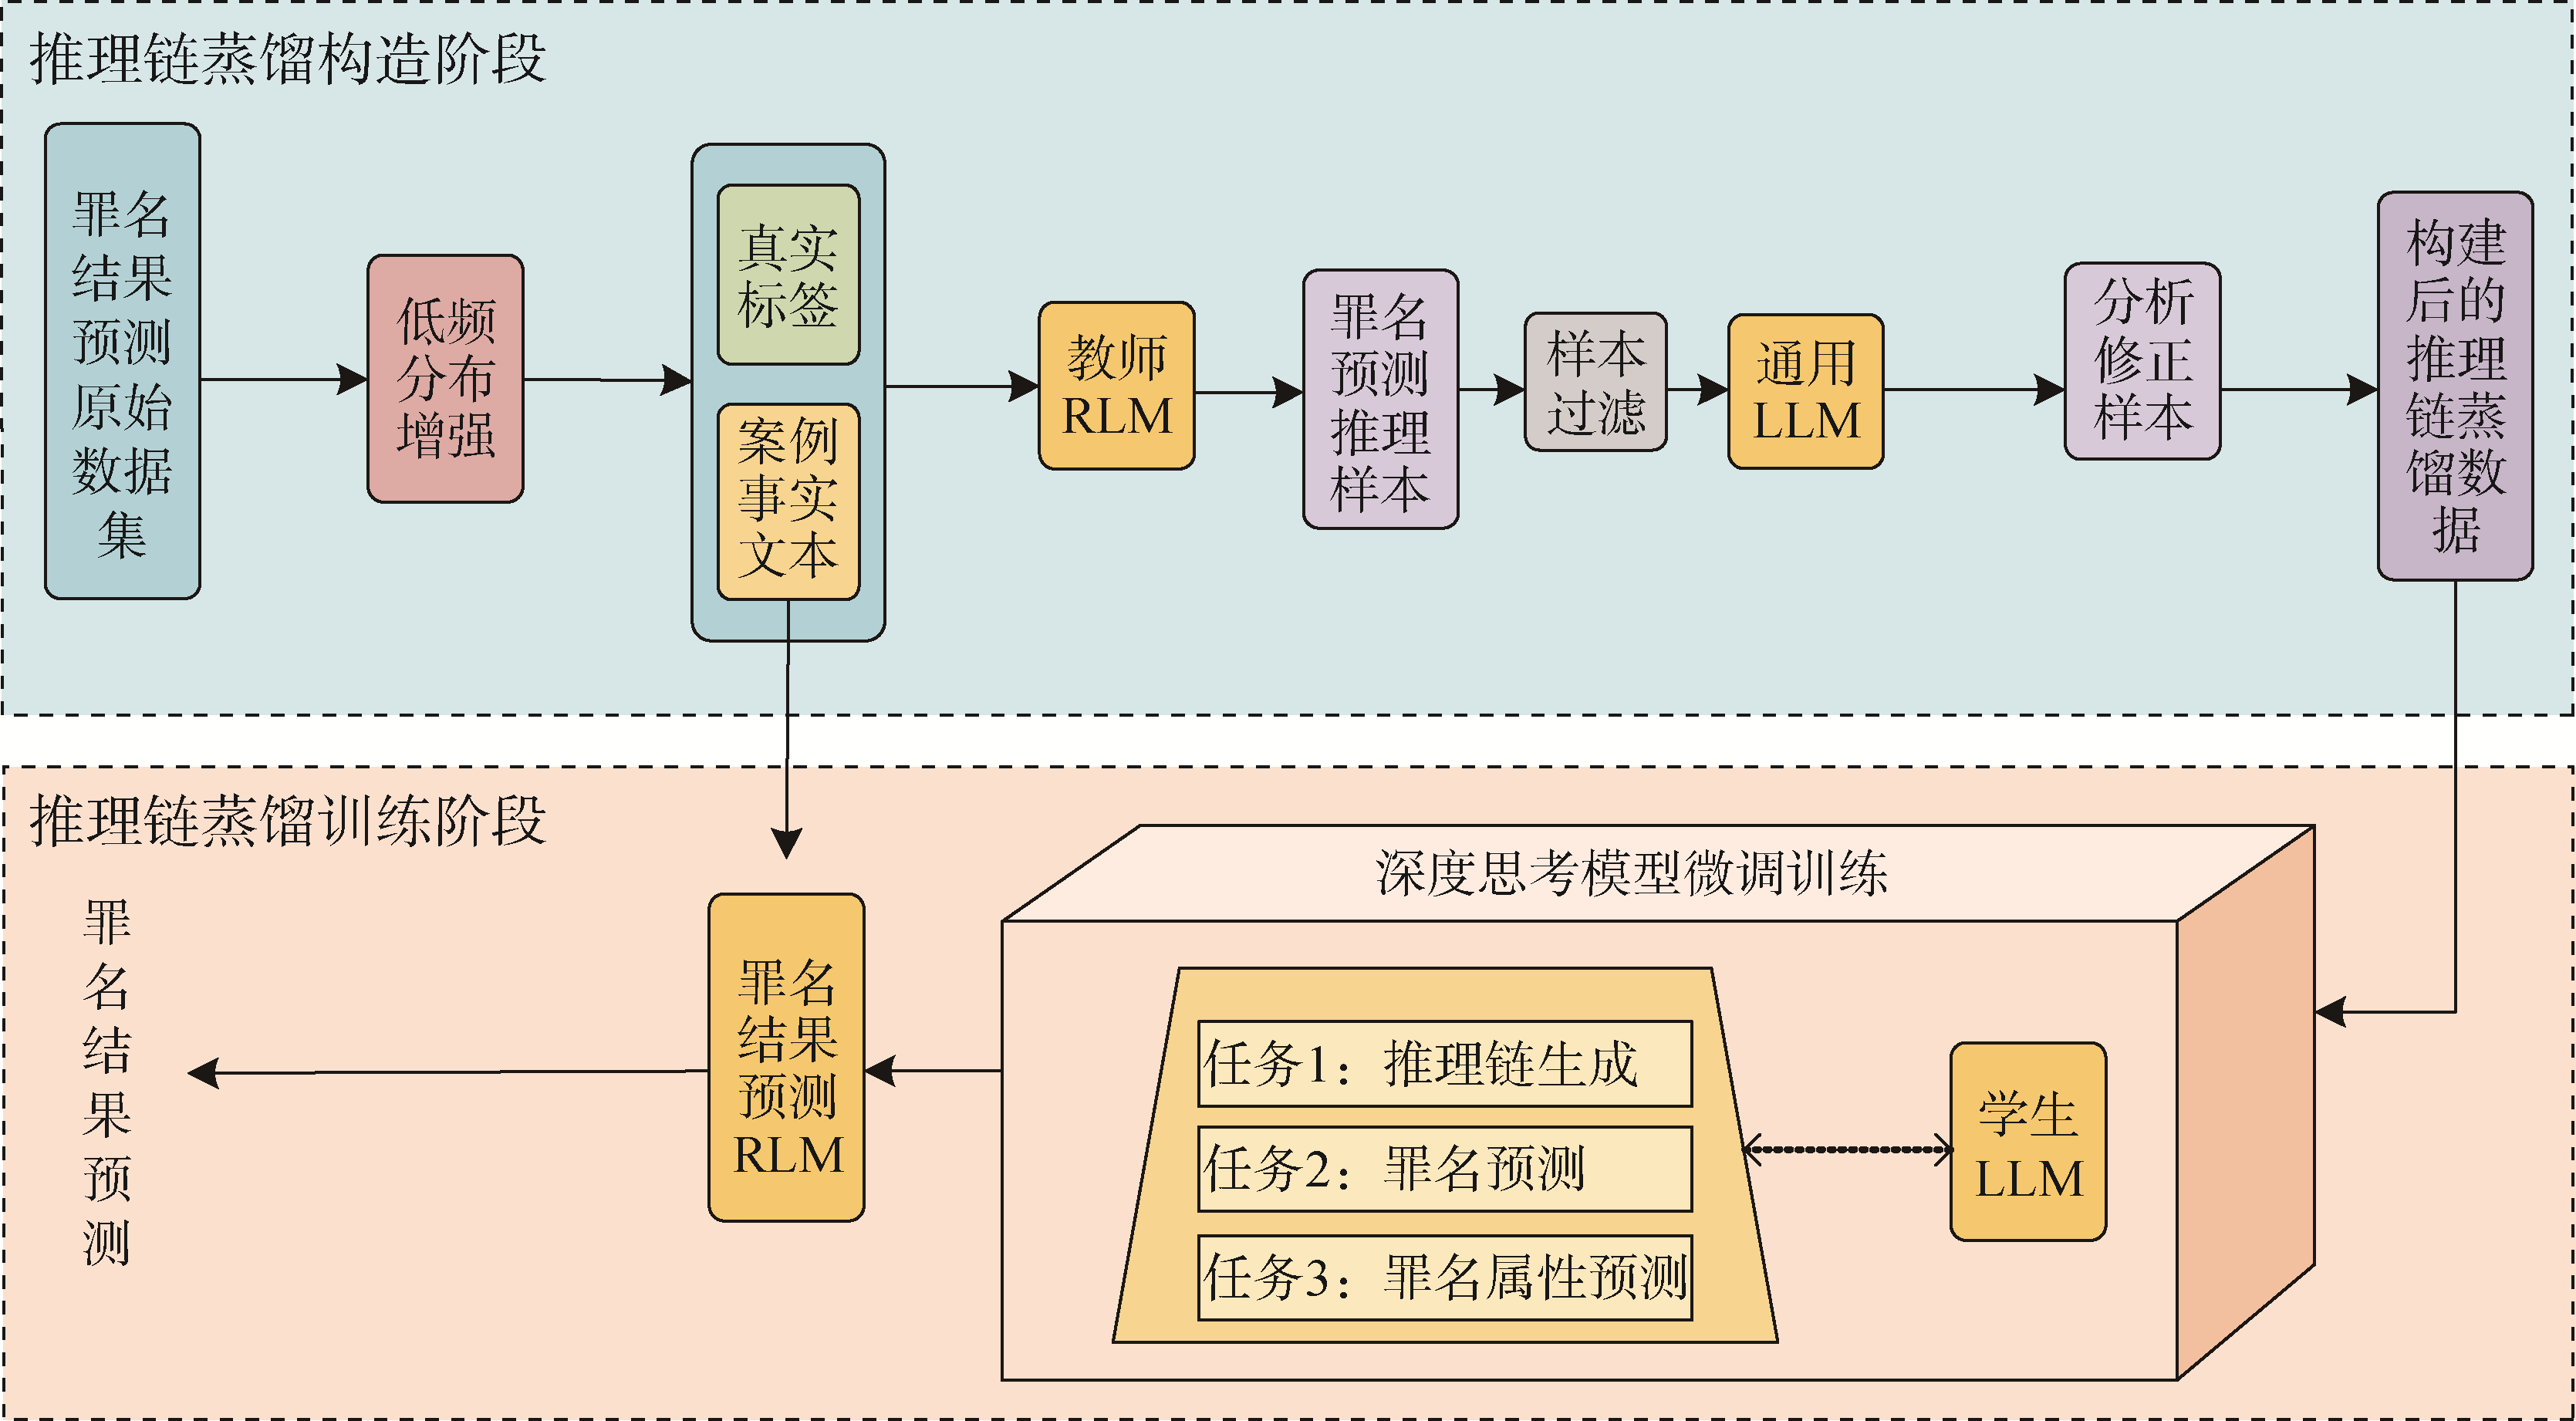
【目的】 通过推理链蒸馏方法,训练具备联合任务深度思考能力的大语言模型,用于司法审判中的罪名预测任务。【方法】 首先利用具备深度思考能力的教师模型构建推理链蒸馏数据集,并通过大模型推理流程对推理链进行校正与优化;随后,训练学生模型学习罪名的推理过程与预测结果。【结果】 在Criminal-S罪名预测数据集上,基于本文方法训练的JudgMind-Distill模型性能超过对比最优基线,且以7B参数量超越671B教师模型,在罪名预测和罪名属性预测任务中的F1值分别提升0.2和18.3个百分点。【局限】 尚未考虑案件中可能存在的多名被告人和多项罪名的复杂情况。【结论】 本文提供一种大模型罪名预测任务训练方法,可将教师模型推理链转化为训练监督信号,在较小参数规模和较高推理效率下提升罪名预测准确性与可解释性,为司法场景中的准确高效罪名预测提供可行路径。